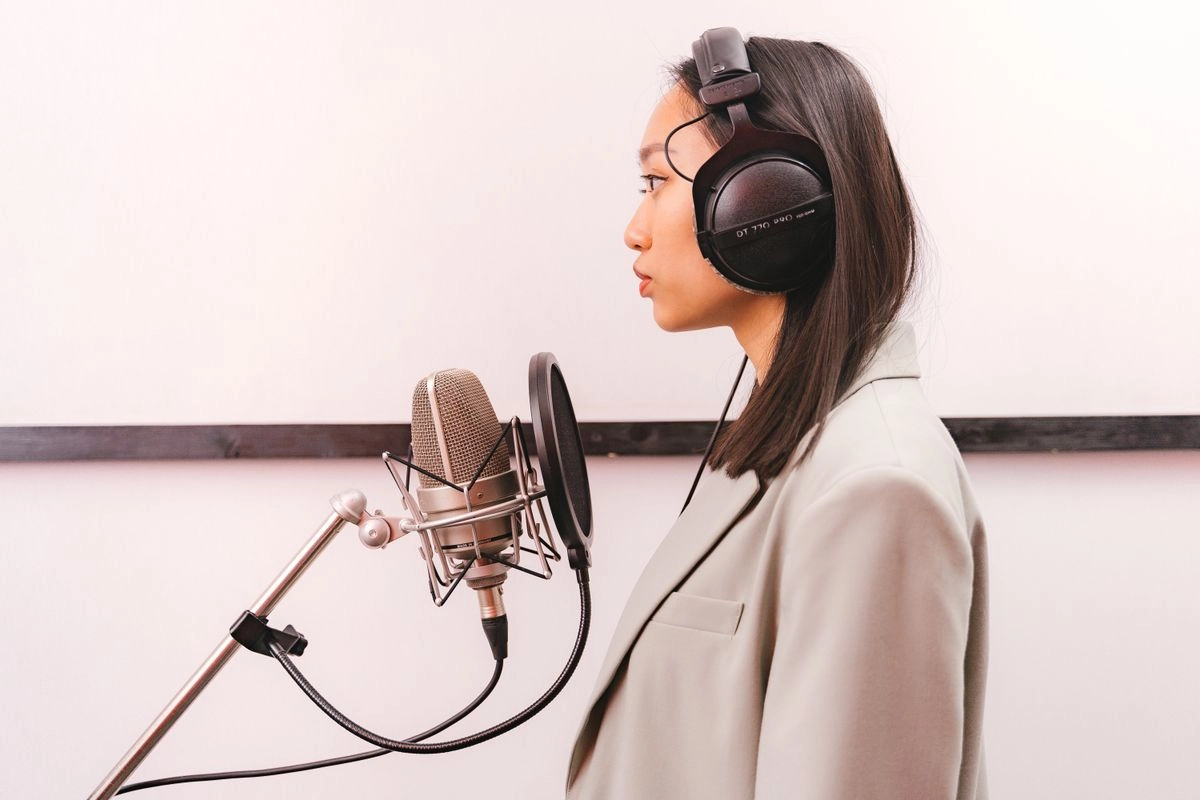
Dữ liệu âm thanh và giọng nói theo hướng case study tập trung vào các bài toán cụ thể: trợ lý giọng nói tiếng Việt, tổng đài tự động, phân loại âm thanh bất thường trong môi trường công nghiệp.
Bài toán thường gặp khi triển khai thực tế
Nhiều mô hình giọng nói hoạt động tốt trong demo nhưng kém chính xác khi gặp giọng vùng miền, tạp âm nền, hoặc cách nói tự nhiên không theo kịch bản chuẩn — khoảng cách giữa dữ liệu huấn luyện và thực tế sử dụng là nguyên nhân chính.
Cách VIETDATA thu hẹp khoảng cách này
- Thu âm thực địa đúng ngữ cảnh sử dụng cuối cùng của sản phẩm (gọi điện, trong nhà xưởng, ngoài trời)
- Đa dạng hoá giọng theo vùng miền, độ tuổi, giới tính người nói
- Gắn transcript có mốc thời gian chính xác đến từng câu/từ
- Phân loại và gán nhãn các loại âm thanh bất thường theo yêu cầu riêng của từng dự án công nghiệp
Dữ liệu bàn giao kèm theo transcript chuẩn hoá, sẵn sàng đưa vào huấn luyện mô hình nhận diện giọng nói hoặc phân loại âm thanh.
Ứng dụng thực tế
- Trợ lý giọng nói nhận diện đa phương ngữ tiếng Việt
- Phát hiện cảm xúc, thái độ qua giọng nói
- Chống gian lận giọng nói giả mạo (deepfake audio)
- Tạo phụ đề tự động cho video, livestream
Thách thức riêng của dữ liệu âm thanh & giọng nói
Tương tự thách thức chung của dữ liệu âm thanh tiếng Việt, các mô hình chuyên biệt như phát hiện cảm xúc qua giọng nói hay chống giả mạo giọng nói (deepfake audio) đòi hỏi dữ liệu đa dạng hơn nữa về sắc thái biểu cảm — cùng một câu nói có thể mang nhiều cảm xúc khác nhau tùy ngữ cảnh, và việc thu thập đủ đa dạng sắc thái này khó hơn nhiều so với chỉ thu giọng đọc trung tính thông thường.
Vì sao chọn VIETDATA cho dữ liệu âm thanh & giọng nói
VIETDATA thiết kế kịch bản thu âm theo đúng sắc thái cảm xúc/ngữ cảnh mà mô hình cần học, không chỉ thu giọng đọc trung tính. Dữ liệu phục vụ các mục tiêu như trợ lý giọng nói nhận diện đa phương ngữ tiếng Việt, phát hiện cảm xúc/thái độ qua giọng nói, chống gian lận giọng nói giả mạo, hay tạo phụ đề tự động cho video/livestream — với mạng lưới cộng tác viên đa vùng miền đảm bảo độ đa dạng giọng nói cần thiết cho các mô hình chuyên biệt này.
Lộ trình hợp tác với VIETDATA
VIETDATA bắt đầu mỗi dự án bằng một buổi trao đổi ngắn để hiểu rõ bài toán cụ thể của mô hình giọng nói — mục tiêu mô hình cần đạt, điều kiện triển khai thực tế, và các ràng buộc riêng (quy định, thời gian, ngân sách). Từ đó đội kỹ thuật đề xuất kịch bản thu thập cụ thể kèm ước tính khối lượng và thời gian, thực hiện một lô dữ liệu thí điểm nhỏ để khách hàng đánh giá chất lượng trước khi cam kết triển khai quy mô lớn. Sau khi lô thí điểm được duyệt, VIETDATA mở rộng theo đúng lộ trình đã thống nhất, kèm báo cáo tiến độ định kỳ để khách hàng luôn nắm rõ tình trạng dự án trong suốt quá trình thực hiện, không chỉ nhận kết quả ở bước cuối cùng.
Xu hướng ứng dụng tại Việt Nam
Trợ lý giọng nói và các ứng dụng xử lý ngôn ngữ tự nhiên tiếng Việt đang được nhiều doanh nghiệp công nghệ trong nước đầu tư phát triển, nhằm phục vụ tốt hơn người dùng Việt Nam thay vì phụ thuộc vào các giải pháp quốc tế vốn chưa tối ưu cho tiếng Việt. Nhu cầu dữ liệu giọng nói đa dạng vùng miền đang tăng nhanh, đặc biệt trong các lĩnh vực tổng đài chăm sóc khách hàng và thiết bị gia dụng thông minh điều khiển bằng giọng nói.
VIETDATA trao đổi phạm vi và báo giá trong vòng 24 giờ.